2025 年顶级视频生成模型
盘点 2025 年最具代表性的视频生成模型,从架构路线、可生成时长与分辨率,到适用场景与取舍建议。
本文为样张 / 骨架页:以下结构供你替换成真实内容,正文排版样式(标题、列表、引用、代码、配图)均已就位。
一句话结论
(用一两句话给出全文结论,方便读者在 3 秒内判断要不要继续读。例如:2025 年视频生成已从「能动」走向「能动得可信」,闭源模型在时长与一致性上领先,开源模型在可控性与生态上追赶。)
为什么是这些模型
(说明筛选标准:训练数据规模、可生成时长、分辨率、开源 / 闭源、社区生态、是否支持图生视频 / 视频生视频。把口径写清楚,后面的对比才站得住。)
横向对比
- 模型 A:架构路线、代表亮点、明显不足
- 模型 B:架构路线、代表亮点、明显不足
- 模型 C:架构路线、代表亮点、明显不足
关键技术点
- 时空一致性:如何让相邻帧之间的人物与场景不「跳变」
- 运动建模:镜头运动与物体运动的分别处理
- 长视频的显存与速度权衡:分段生成 + 拼接的常见做法
引用:把行业里一句有代表性的话放在这里。blockquote 样式已就位,左侧主色竖线 + 浅底圆角。
一段示例代码(演示 code / pre 样式)
# 本地跑一个最小推理示例(占位命令,替换为真实参数)
python infer.py --model model-a --prompt "一只猫在窗台上晒太阳" --seconds 5
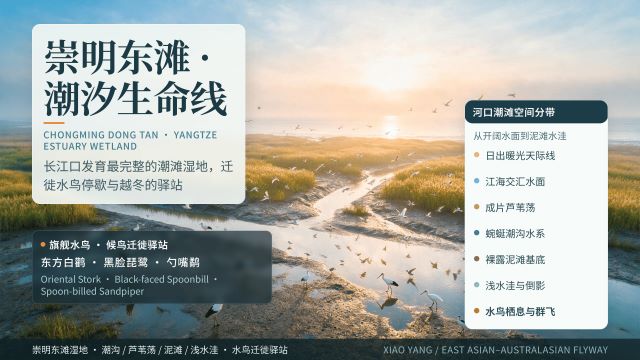
配图示例
(在 public/upload 放一张图,用 Markdown 直接引用即可;图片样式已就位:圆角 + 自适应宽度,不会溢出内容列。)
小结
(收尾:适用人群、选型建议、后续值得关注的方向。把「结论」再凝练一遍,给读者一个可执行的下一步。)